Getting the transcript
Reading the captions from YouTube. A video nobody has opened here before takes 10 to 30 seconds; this page fills in on its own.
Getting the transcript
Reading the captions from YouTube. A video nobody has opened here before takes 10 to 30 seconds; this page fills in on its own.
MahlerLab · @MahlerLab
Words
1,748
Runtime
13:40
Speaking pace
128wpm
Reading time
7min
128 words per minute, below the 160 25th percentile of 349 measured videos. That distribution comes from the 349-video hook study.
Opening (first 30 seconds)
네, 안녕하세요. 자, 타입세이 AI라는 곳에서 제브라고 하는 새로운 AI 모델을 발표를 해서 어, 흥미로운 거 같아 가지고 한번 들고 와 봤습니다. 자기들 말로는 이제 시스템 모델이다. 그리고 이제 퍼블릭하게 발표된 첫 번째 모델이다라고 이야기를 하고 있습니다. 자, thinking fast and slow에서 말하는 시스템 원 thinking이죠. 이렇게 즉각적인 판단을 내리는 거. 그래서 소개를 한번 보시면 우리가 흔히 AI라고 이야기를 하면 라즈 랭귀지 모델 기반의
64 words, the words spoken in the first 30 seconds at 128 words per minute.
Free, no signup. See how the first 30 seconds hold attention, with rewrites.
Sentence shape
| Measure | This transcript |
|---|---|
| Sentences | 153 |
| Average words per sentence | 11.4 |
| Longest sentence | 61 words |
| Questions asked | 5 |
| Sentences containing a number | 27 |
Most used terms
What this transcript is
Every word below is the caption track YouTube publishes for this video, pulled from the video itself and reproduced unchanged. It is not Prepublish's writing, not a summary, and not a re-transcription: it is the video's own published captions. Korean captions, generated automatically by YouTube, in the video’s original language. Source: the video on YouTube. A channel that would rather this page did not exist can ask for its removal through the contact page, and it is removed.
No Script X-ray for this video: YouTube shows a Most replayed graph only once a video has enough views.
네, 안녕하세요. 자, 타입세이 AI라는 곳에서 제브라고 하는 새로운 AI 모델을 발표를 해서 어, 흥미로운 거 같아 가지고 한번 들고 와 봤습니다. 자기들 말로는 이제 시스템 모델이다. 그리고 이제 퍼블릭하게 발표된 첫 번째 모델이다라고 이야기를 하고 있습니다. 자, thinking fast and slow에서 말하는 시스템 원 thinking이죠. 이렇게 즉각적인 판단을 내리는 거. 그래서 소개를 한번 보시면 우리가 흔히 AI라고 이야기를 하면 라즈 랭귀지 모델 기반의 어떤 툴들을 이야기를 하죠. 이거 같은 경우에는 일단 출력이 사람이 읽을 수 있는 자연화로 되 있는 텍스트에 해당을 합니다. 그런데 많은 경우에는 이거를 자연화 생상이 아니고 어떤 판단을 내리는데 어 사용을 하고 있다. 그래서이 자연으로 줄줄줄줄 어떤 생각을 넓는 형태는이 시스템 2 모델에 해당을 하는 거고 이제 자기들이와 같은 시스템 원이 이런 즉각적인 판단에는 더 적당 적절하다. 요런 식으로 이야기를 하고 있습니다. 그래서 우리가 제브라는 자기네들 사이 타입 세이프의 플렉션 모델을 발표를 한다 이러고 있습니다. 그러면 이제 라즈랭기지 모델이 아니다. 그럼 뭐가 다르냐? 출력할 수 있는게 다릅니다. 출력을 딱 이렇게 세 가지로만 할 수가 있어요. 초이스 아니면 스코어 나올 이렇게 있습니다. 초이스 같은 경우에는 객관식 문제입니다. 그래서 초이스 옵션들이 주어지면 각각이 몇 % 확률로 이거인 거 같다. 어느 정도 확신한다. 이렇게 점수를 주고 스코어는 루브리그 줍니다.이 비슷하죠? 비슷해서 어네 비슷하게 뭐 몇 몇 각 점수가 확률이 얼마이고 어느 정도 확신한다 이렇게 주고 이제 나올 같은 경우에는 참이냐 거짓이냐 0에서 1까지의 연속값으로 답을 해 주는 이런 식입니다. 그래서 출력이 정말 아주 간단한 제이선 형식으로 돼 있어요. 예시를 볼까요? 어, 초이스 같은 경우에 예를 들어서 어떤 코드를 쭉 주고이 코드가 무슨 언어로 되어 있는 거 같냐라고 물어보면 뭐 파이썬이다, 자바스크립이다 이렇게 답을 하겠죠. 네. 그런데 llm 같은 경우에 그냥 물어보면 답을 할 텐데이 타입 시스템 원인 제 같은 경우에는 옵션을 주어 줘야 됩니다. 그리고 그 옵션들 중에서 어, 강 선택이 강제가 됩니다. 그래서 이제 요런 식으로네 질문을 하게 되면 이제 대답이 네. 요렇게 어 각각의 확률 뭐 이게 어 시핑이냐 리턴이냐 빌딩이냐 할 때 아 이건 리턴에 해당하는 뭐 그런 채팅이다라는 거죠. 이런 식으로 답을 하게 됩니다. 그리고 어느 정도 확신한다. 이런 스코어를 줄 수가 있습니다. 그래서이 또 스코어가 어 확신이 부족하다라고 할 때 또 다른 방식으로 대응한다거나 요런 식으로 활용을 할 수가 있겠더라고요. 나올 같은 경우에는이 대답이네 이런 식으로 나올네 0.99 99 뭐 0.93 이렇게 됩니다. 아, 그리고 재밌는게 질문을 한꺼번에 여러 개를 할 수가 있습니다. 그럼 이거를 자기들의 경우에는 순차적으로 토큰을 하나하나씩 하나씩 이어붙여서 하는게 아니고 병렬 처리를 해서 어, 질문을 많이 하더라도 대답을 하는데 시간이 증가하지 않는다라고 이야기를 하고 있어요. 그리고이 출력이 굉장히 빠르고 싸기 때문에 자기들은 입력되는 토큰에 대해서만 과금을 하고 출력에 대해서는 과금을 안 한다라고 되어 있습니다. 음. 음. 그래서 제가 실제로 한번 어 승인을 받아 가지고 사용을 해 봤거든요. 지금 타입 세이프 같은 경우에 이제 웨이팅 리스트가 있습니다. 여기다 등록을 하셔 가지고 승인을 받아 가지고 적근 권한을 얻을 수가 있습니다. 저 같은 경우 나온 첫날 바로 해 가지고 오늘 아침에 승인을 받았거든요. 그래서 관심 있으시면 신청하시고 이제 뉴시지를 한번 보시면네 제가 오늘 사용을 한게에 2.8밀리언 8밀리언 토큰을 사용을 했고 그리고 이제 과금은 11cm밖에 안 됐습니다. 굉장히 싸죠. 예. 그래서 과격 걱정 없이 쓸 수가 있다. 그리고 속도도 굉장히 빠릅니다. 자기들 주장으로는 어 프론티어 LRM에 비해서 수백 싸고 뭐 수천배 빠르다. 뭐 이런 식으로 이야기를 하고 있습니다. 뭐 비교한 대상에 따라 좀 다를 수가 있겠죠. 그래서 이제이 모델을 가지고 저 같은 경우 연구에 활용을 하고 있으니까 이거를 한국어 의학 텍스트에 저는 주로 적용을 하니까 활용할 수가 있을까 궁금한 거죠. 그런데 예전에 채지 3.5 나왔을 때 생각을 해 보면 한국어로 된 거를 그냥 그대로 사용을 하면 안 되거든요. 예. 번역을 해서 영어로 해야지 재성능이 나왔습니다. 그래서 혹시 그런가 싶어 가지고 이제 한번 벤치마킹을 간단하게 해 봤습니다. 몇 가지 한국어 영어 벤치마크를 백문제에 대해서 간단하게 한번 돌려봤고요. 그래서 한국어 텍스트에 그대로 써도 될까 아니면 영어로 번역을 해야 될까? 이거를 제가 판단을 내리기 위해서 간단한 표본 점검을 한번 해 봤습니다. 100문제이기 때문에 한 8점 정도는 차이가 나야 이제 의미 있는 차이라고 이야기를 할 수가 있습니다. 간단한 요약을 드리면 한국어로 해도 되는 거 같습니다. 그리고 어 뭐 세밀란 의미 판단은 조금 어렵고 그리고 어 인스트럭션 부분 여기 가시면 예 이렇게 질문을 할 때이 데이터에 해당하는 부분이 있고 그다음에 여기 인스트럭션이 있거든요. 그래서 예전에 채치비트 같은 경우에는 뭔가 지문을 한국어로 주고 인스트럭션만이라도 영어로 고치면 좀 더 성능이 잘 나오는 그런 경향이 있었는데 어 딱히 그런 경향이 관찰되지 않았습니다. 그리고 이제 의학 문제 어 뭐 제가 이제 데이터를 보면서 한번 또 설명을 드리겠습니다. 일단은 어 벤치마크 그 문항을 한번 보시면 이렇게 벨레벨레라는 벤치마크고요. 이렇게 우리 어렸을 때 풀었던 도캠집이랑 비슷하죠.이 이 한 문단 정도 데이터가 주어지고 어 여기서 이제 질문이 있고 그 질문에 대한 답을 1 2 3 4 중에서 하나 옳은 것을 고르는 그런 방식입니다. 그리고이 벤치마크 같은 경우는 다국어로 번역이 되어 있습니다. 그래서 그중에서 이제 제가 한국어를 선택을 해 가지고 똑같은 내용입니다. 그리고 이제 문항도 같고 보기도 같아요. 답은 똑같이 2번입니다. 이거를 맞았냐 틀렸냐 한번 평가를 해 봤고 그다음에 이제 퍼즈 X라는 건데 구글에서 만든 건데 어 이렇게 이런 문장이 있습니다. 그리고 이거를 살짝 변형한 그런 문장이 있고이 두 문장의 내용이 완벽하게 일치하냐 아니냐를 물어보고 있습니다. 얘 같은 경우에는 거의 같은데 여기네 펠트 키르히 지구에 있다라는 말은 여기에 없거든요.네 예, 영어로 되어 있는 걸 보셔도 예, 이제 벨트 키르히에이 부분이 여기에 이제 없습니다. 한쪽에는 네. 그래서 어 이게 있냐 없냐로 동동하지 않다라는게 답이 됩니다. 그래서 ox 퀴즈긴 한데 어 상당히 까다롭습니다. 자세히 보지 않으면 틀릴 수 있는 그런 내용이에요. 그리고 이제 마지막으로 벤치마크를 해했던 거는 예 한국어로 되어 있는 한국 의사 국가 시험 면허 시험 문제입니다. 어 이거 지금 저 예시를 한번 랜덤하게 뽑아 달라고 해서 지금 짧은게 뽑혔는데 예 이런 문제가 있고 이제 1 2 3 4 5번 중에서 예 하나씩 고르게 됩니다. 이제 문제는 뭐 필요한 검사는 아니면 뭐 진단은 아니면 뭐 치료는 뭐 이런 것들을 물어보거든요. 그리고 이제 매드 QA 같은 경우에는 영어로 되어 있는 미국 의사 면허 시험입니다. 근데 이쪽은 조금 더 쉬워요.
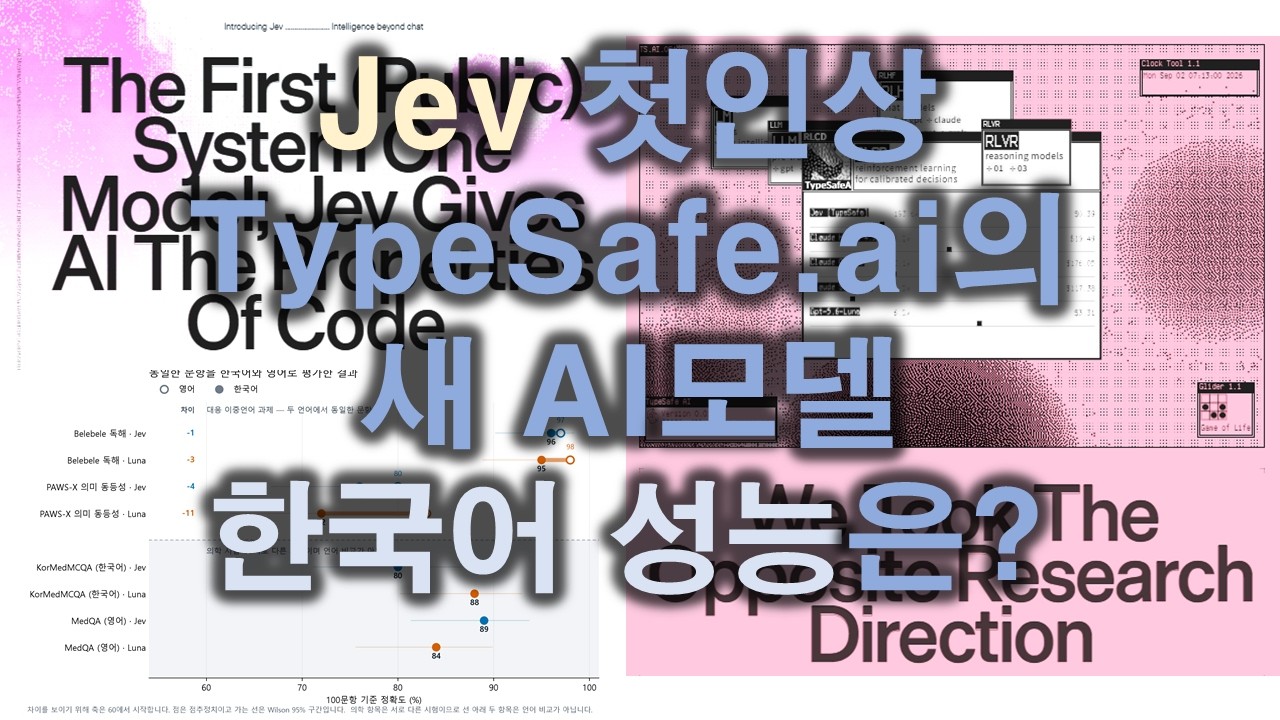
A B C D네 개 중에서 하나를 고르는 그런 방식입니다. 그래서 간단한 벤치마크를 한번 돌려봤더니 이제 벨레벨레 같은 경우에는 이제 96 97점이 나왔습니다.이 이 표를 보시는 거는이 꽉 차 있는 동그라미는 한국어 뻥 뚫려 있는 건 영어입니다. 그래서 영어로 되어 있는 거를 이제 한국어로 풀었을 때 1점 떨어진다라고 보시면 되겠죠. 그래서이 96 97점이 그러면 괜찮은 점수인가를 판단하기 위해서 GPT 모델 중에서 제일 약한 모델인 루나에서 리즈닝을 끄고 리즈닝 레벨을 넌으로 놓고 한번 풀게 시켜 봤습니다. 루나, 테라, 솔, 아스트라 이렇게 있죠. 그 중에서 이제 제일 낮은 모델입니다. 그랬더니 영어로 하면 98점, 한국어로 된 거는 이제 95점 이렇게 됐습니다. 앞에서 같은 문장 의미이냐를 물어보는 파워 X 있었죠. 제브한테 풀어 보라고 했더니 영어로 된 거 80점밖에 못 맞추더라고요.
X 퀴즈인데 80점이면 굉장히 낮은 거죠. 예. 그리고 한국어로 된 건 또 거기서 더 내려가서 76점이었어요. 그래서 어 이렇게 났나 싶어 가지고 루나한테 물어봤더니네 루나도 잘 못 맞춥니다. 꽤 어렵나 봐요. 그래서 83점에서 72점으로 좀 차이가 크긴 한데 이제 영업끼리 비교해 보면 3점 이제 한국어끼리 비교해 보면 4점으로 뭐 비슷비슷하다라고 볼 수가 있겠습니다. 제브나 루나나 이제 비슷비슷하다. 다음으로 이제 의학적인 도메인에서의 지식을 물어보는 거죠. 그 경우에 이제 제 같은 경우에는 한국어 문제 같은 경우에 80% 맞췄고 루나가 88점입니다. 그래서이 88점 같은 경우에는 이제 다 나머지들 다 비슷비슷했는데 꽤 많이 떨어졌죠. 예. 8점 정도 떨어졌고 매드 QA 같은 경우에는 어 재밌게도 루나가 84점인데 제브가 89점으로 5점 더 높았습니다. 예. 그래서 요런이 언어에 따라서 상반되는 그런 결과가 나와 가지고 아 이거 어떻게 해야 되지? 예. 지금 좀 고민 중입니다. 그래서 일단은이 프리미너리 한 결과만 놓고 봤을 때는 한국어 의학 텍스트는 어 주의해서 사용해야겠다. 뭐 이런 생각을 하고 있습니다. 그래서 이렇게 루나와 제브를 비교를 해 봤을 때 코르메드 QA에서 8점 차이가 나더라. 네. 그래서음 그리고 뭐 중간에 이제 인스트럭션 하는 그 문장도 이렇게 좀 언어를 바꿔 보고 했거든요. 그래서 결론은 어 한국어로 사용을 해도 큰 문제가 없겠다. 일반적인 문장들 해석 같은 거 잘한다. 그리고이 퍼 X 같은 경우에는 어 그냥 어려워하는데 그게 문제 자체가 어려워서 그런 거 같습니다. 네. 그리고 중간에 이제 인스트럭션 문장 이렇게 어 물어볼 때요 인스트럭션 문장 요거를 영어로 바꾸는 거 굳이 할 필요 없다. 그냥 한국어로 쭉 해도 되겠다. 그 결론입니다. 그리고 이제이 의학 점수 같은 경우에는 제가 조금 더 추가적으로 지금 좀 더 한번 파보고 있습니다. 네. 어, 잠깐 이제 뭐 결론을 보여 드리면 이제 제브한테이 코르메드 MCQA를 전체 문제를 풀게 해 보고 이제 매드 QA도 1273문제 다 풀어보게 한번 시켰거든요. 앞에서 보여 드린 거는 100문제로 제가 파일럿을 돌려본 거고 그래서 이제 루나랑 비교를 해 보면 루나가 한국 국시 같은 경우는 92% 재는 86% 그래서 한 6점 정도 차이가 나고 어 매드의 미국 같은 경우에는 86점 87점으로 오히려 제부가 1점 높게 나왔습니다. 그래서 거의 뭐 비슷하다고 볼 수가 있겠죠. 어 그런데 여기다가 제가 한번 루나 맥시징을 한번 해 봤습니다.이 루나 모델이 GPT 모델 중에서 제일 약한 모델이잖아요. 그런데 얘한테 중간에 리즈닝 에트를 최대한으로 켜 놓고 막 생각을 해 가지고 중간에 리징 토큰을 태워 가지고 한번 답을 맞추게 하면 성능이 꽤 올라가는 걸로 알려져 있습니다. 그래서 오히려 뭐 테라 모델이나 솔에 리즈닝 끈 거보다 루나한테 생각을 많이 하도록 해서 하는 것이 오히려 가격도 싸고 성능도 좋다라는 말이 있어 가지고 이제 루나 맥싱이라고 부르거든요. 네. 그렇게 했더니 어 점수 높죠. 97.7%에 95.6%를 6%를 맞췄습니다. 그러면 이렇게 비교를 해 보면 예, 성능 차이가 꽤 납니다. 물론 이제 가격도 더 비싸지긴 하겠지만요. 그래서 이제 제가 지금 생각을 하고 있는게 그렇다면 제브가 자기가 문제를 풀 때 컨피던스가 있잖아요. 그 컨피던스를 이용을 해서 좀 아리까리하다 싶은 거는 루나한테 보내 가지고 풀게 시키면 더 점수가 올라가지 않을까 그러면서도 쉬운 거는 자기가 시스템을 이용해서 풀고 어려운 거는 시스템 2를 이용해서 풀면 어 효율적으로 풀 수 있지 않을까라는 가설을 가지고 지금 뭐 이것저것 한번 어 해보고 있는 중입니다. 예. 그렇게 했더니 이제 제트 루나 맥스가 이거거든요. 자기가 컨피스가 떨어지는 20%를 루나 맥스한테 시키는 거예요. 그렇게 했더니 점수가 한 92.9% 이렇게 나옵니다. 그래서 이제 제가 궁금해하는 거는 이제 파르톨 프런티어라는 표현을 흔히 사용을 하죠.
X축은 가격입니다. y축은 정확도. 예. 여기가 성능이죠. 그러면 당연히 이제 가격이 올라가면 올라갈수록 성능이 올라가겠죠. 근데 그중에서 이제 밸런스를 하는 거죠. 싸게 해서이 정도 풀 수 있는게 적절한 그런 상황도 있을 거고 시간을 충분히 들여 가지고 했을 때 예 비용을 비용과 시간을 충분히 들여서 풀었을 때 어 의미가 있는 그런 경우도 있을 거고 뭐 중간 정도의 이제 타협점도 있을 거고 이제 그런 것들 한번 이제 여러 가지 모델과 세팅을 한번 어 테스트를 해 보고 있는 중입니다.네 그래서 재밌는 결과가 나올 것 같아요. 나중에 또 발표를 하도록 하겠습니다.네 네. 이렇게 해서 이제 정리를 하자면 어 타입 세이프 AI에서 제브라는 자칭 시스템 모델이 나왔다. 그래서이 모델 같은 경우에는 어 자연어로 답을 하는게 아니고 굉장히 스트릭트한 스키마 안에 딱 갖춰 가지고 초이스나 스코어 루브릭에 따른 스코어 아니면 예스 노로 답할 수 있는 나올 이런 형태로 답을 한다. 네. 그래서 이것들을 이제 앞으로 우리가 LLM이 토큰을 막 태워 가지고 답을 하는 그런 거라면 이제 즉각적으로 빠르게 싸고 빠르게 어떤 판단을 내리는 형태의 어 시스템 원 형태로 이렇게 조합해서 사용할 수 있게 되지 않을까 요렇게 생각이 들었습니다. 네.이 이 정도 마무리하겠습니다.
The words are the caption track's own and nothing is reworded or re-transcribed. Paragraph breaks are placed between sentences so the text reads as prose.
Free tools for your own script. No signup, no login.
Paste your draft and see where viewers are likely to drop off, with a rewrite for each weak line.
Paste the first 30 seconds of your own draft for a hook score and rewrites.
Check your draft against YouTube's advertiser-friendly guidelines before you record it.
Read this channel's public videos and transcripts, and download a writing brief for it.