Getting the transcript
Reading the captions from YouTube. A video nobody has opened here before takes 10 to 30 seconds; this page fills in on its own.
Getting the transcript
Reading the captions from YouTube. A video nobody has opened here before takes 10 to 30 seconds; this page fills in on its own.
Tarvo Treier · @TarvoTreier
Words
3,447
Runtime
38:29
Speaking pace
90wpm
Reading time
14min
90 words per minute, below the 160 25th percentile of 349 measured videos. That distribution comes from the 349-video hook study.
Opening (first 30 seconds)
Selles videos lo väikese rakenduse Dotnet 10-ga, kus saame tudengeid hallata ja nendele tulemusi kirja panna. Näiteks küsime tudengite nimekirja, lisame uue tudengi ja märgime talle kursuse eest punkte. Kasutame minimal upi lähenemist. Alustame ühest failist. Kui loogika tuleb juurde, jagame selle sobivatesse failidesse laiali.
45 words, the words spoken in the first 30 seconds at 90 words per minute.
Free, no signup. See how the first 30 seconds hold attention, with rewrites.
Sentence shape
| Measure | This transcript |
|---|---|
| Sentences | 443 |
| Average words per sentence | 7.8 |
| Longest sentence | 21 words |
| Questions asked | 8 |
| Sentences containing a number | 40 |
Most used terms
Run the check on the words above: where attention is likely to drop, with a rewrite for each weak line. The free check shows the scores and the one issue costing the most.
What this transcript is
Every word below is the caption track YouTube publishes for this video, pulled from the video itself and reproduced unchanged. It is not Prepublish's writing, not a summary, and not a re-transcription: it is the video's own published captions. Estonian captions, generated automatically by YouTube, in the video’s original language. Source: the video on YouTube. A channel that would rather this page did not exist can ask for its removal through the contact page, and it is removed.
No Script X-ray for this video: YouTube shows a Most replayed graph only once a video has enough views.
Selles videos lo väikese rakenduse Dotnet 10-ga, kus saame tudengeid hallata ja nendele tulemusi kirja panna. Näiteks küsime tudengite nimekirja, lisame uue tudengi ja märgime talle kursuse eest punkte. Kasutame minimal upi lähenemist. Alustame ühest failist. Kui loogika tuleb juurde, jagame selle sobivatesse failidesse laiali. Koodi ei ole vaja pähe õppida. Jälgi pigem, kust kohast päringu sisend tuleb, mida meie kood sellega teeb ja millise vastuse klient lõpuks saab.
Paneme kõigepealt paika kaks tegevust. Sellelt aadressilt küsib GET tudengite nimekirja. Post samale aadressile lisab uue tudengi. Aadress on sama, aga meetod ütleb, mida teha soovime. Ülejäänud tegevuste juurde jõuame hiljem. Lisamispäringu puhul tuleb tudenginimi kaasa Jason kujul päringu kehas. Päises ütleme, et saadame Jasoni. Vastuses vaatame nii olekukoodi kui ka tagastatud andmeid. Vaatame neid osi kohe töötava rakenduse juures.
Alustame tühjast projektist ja paneme kõigepealt ühe päringu tööle. Seejärel lisame pärisandmed ja vajalikud käitumisreeglid. Terminalis loon projekti käsuga DNET new webeb. Nimeks panen student application. Valin Dotnet 10 ja selle kohaliku näite jaoks HTTP, et sertifikaatide seadistamine meie esimest käivitamist ei segaks. See mall annab väikese veebirakenduse alguse. Appi jaoks vajalikud osad lisame ise. Seejärel liigun loodud projekti kausta.
Avan projekti VS Codeis. Programm CS on meie rakenduse alguspunkt. Great builder valmistab ette seadistuse ja teenused. Build loob veebirakenduse. Siin all on üks getpäringu käsitleja, mis vastab tekstiga Hello World. Viimane rida käivitab serveri. Seda tervituspäringut kasutame kohe kontrolliks, et projekt meie arvutis üldse töötab. Lisame Open toe. See annab meie appist masinloetava kirjelduse. Millised päringud on olemas ning millist sisendit ja väljundit need kasutavad.
Paketi lisamise järel registreerime Open Upi teenuse rakenduse käivituskoodis. Kirjelduse vaatamiseks lisame skalari. See on brauseris avanev tööriist, kuskohas saame valida päringu, anda sisendi ja vaadata vastust. Open kirjeldab appit. Skalar kasutab seda kirjeldust, et me saaksime appiga mugavalt katsetada. Teenuse registreerimisest üksi veel ei piisa. Pärast pildkutset lisame aadressid, mille kaudu Openapi dokumentides kalar kättesaadavaks muutuvad.
Selles projektis avame need ainult arenduskeskkonnas. Nii ei avaldame neid tööriistu sama seadistusega automaatselt igas keskkonnas. Meie kohalik käivitusprofiil kasutab development keskkonda. Projektimall valis meile pori ise. Panen launch settings failis http profiili poriks 5180. Nii on kogu õpetuses sama aadress ja seda on lihtsam jälgida. Kui see port on sinu arvutis kasutusel, vali teine vaba port, siis kasuta oma porti ka brauseris ja kõigis näidispäringutes.
Brauseris tuleb vastu Hello World. See on meie esimene kontrollpunkt. Projekt kompileerub, server töötab ja me jõuame teemani õigelt aadressilt. Kui siin vastust ei tule, tasub enne järgmiste failide lisamist see koht korda teha. Avan nüüd skalari, valin meie getpäringu ja saadan selle. Siin on olekukood 200 ja vastuse kehas on sama tervitus. Nüüd näeme eraldi ka HTTP vastusei, mida tavaline brauserivaade meile nii selgelt ei näidanud.
Edaspidi kontrollime muudatusi siin. Töötav kood peab andma ka oodatud vastuse. Tervituse asemel tahame töötada tudengitega. Loon selleks eesent klassi. ID eristab kirjeid. Nimi üksi ei sobi identifikaatoriks, sest mitmel tudengil võib olla sama nimi. East eliit märgib, kas tudeng on kustutatuks loetud. Alguses on see false. Kustutamise käitumise teeme hiljem. Praegu paneme mudeli paika. Vaatame meie student klassi. Siin on ka east eliid.
Kas klient peab seda välja nägema? Praeguse appi puhul ei pea. Talle saadame identifikaatori ja nime. Selle vastuse kuju kirjeldame eraldi tüübiga Student Respons. See on meie väljundi TTO ehk andmeedastuse objekt. Nii otsustame ise, millised andmed appi kaudu välja lähevad ega tagasta automaatselt kogu andmehoidla objekti. Väljundi jaoks on meil Student Response, milles on ID ja nimi. Uue tudengi lisamisel saadab klient ainult nime.
Identifikaatori määrab andmehoidle. Selle sisendi jaoks loome great student request tüübi. Muutmise jaoks on eraldi update student request. Praegu sisaldavad mõlemad sisendid sama välja. Eraldi nimed näitavad, millise tegevuse andmetega on tegu. Siin näiteks kirjeldame need väikesed andmetüübid recordidena. Järgmiseks vajame kohta, kus tudengite andmeid hoida. Kasutame Entity Framework Cori ehk EF Cori. Selle kaudu saame koodis andmeid küsida ja muudatusi salvestada.
Selles videos valime Inmemory andmehoidla. Andmed asuvad meie rakenduse protsessi mälus. Eraldi andmebaasiserverit ei ole selle näite käivitamiseks vaja. Sellel valikul on üks oluline tagajärg. Kui protsess lõppeb, kaovad ka mälus olnud andmed. Järgmisel käivitamisel loome aga algandmed uuesti. In memory sobib meile siin appi õppimiseks. Ta ei ole relatsiooniline andmebaas ning me ei saa tema põhjal kontrollida kõiki päris andmebaasi piiranguid või päringute käitumist.
Loon data kontekst klassi, mis pärineb FCori TB kontekst. Students omadus annab meile ligipääsu tudengite kogule. Siia lisame ka mõned algsed tudengid. Nii saame esimese päringuga kohe midagi tagasi. Üks seadistus väärib veel märkimist. Päringufilter jätab tavalistesse päringutesse ainult tudengid, kelleit on false. Praegu on kõik meie tudengid aktiivsed. Kustutamise juures näeme, kuidas see filter tulemust muudab. Endpoint hakkab kohe data konteksti kasutama.
Kes selle objekti loob? Laseme seda teha asp.netoril. Ühe HTTP päringu jaoks luuakse kontekst, mida selle päringu töökäigus kasutatakse. Järgmine päring saab oma konteksti. Seda eluiga nimetatakse scoped eluaks. TB kontekst hoiab muuhulgas meeles loetud ja muudetud objekte. Me ei jaga üht sellist muutuvat tööolekut korraga kõigi päringute vahel. Adv kontekst ütleb raamistikule, kuidas meie data konteksti luua. Siin valime talle inmemori andmehoidla.
Hiljem kirjutame endti parameetriks data konteksti ja raamistik annab selle meile. Seda nimetatakse sõltuvuse süstimiseks. Käsitleja ütleb, mida tal tööks vaja on, kuid ei pea seda objekti ise looma. Registreerimine toimub enne pildkutset. Rakenduse käivitamisel palume Fkooril andmehoidla luua. Meie seadistatud algandmed lähevad sellega samuti sisse. Siin ei ole veel saabunud ühtegi http päringut. Seepärast loome konteksti kasutamiseks ise ajutise skoobi.
Uusing block hoolitseb selle eest, et pärast algandmete ettevalmistamist see skoop ja tema teenused vabastatakse. Kirjeldame getpäringu tudengite aadressile. Sulgudes küsib käsitleja data konteksti. See ongi koht, kus raamistik meile registreeritud teenuse annab. Päringu lõpus kasutame praegu toolist meetodeid. Nii saame kõigepealt töötava sünkroonse variandi. Seejärel muudame sama päringu asünkroonseks ja vaatame, mis selle juures tegelikult muutub.
Päring algab tudengite kogust. Select ütleb, millise kujuga tulemust tahame. Igast tudengist võtame identifikaatori ja nime loome student response objekti. Tulist paneb kirjeldatud päringu tööle ja kogub vastused nimekirja. Sellepärast kirjeldame soovitud väljad enne tolist kutset. As no tracking märgib lugemispäringu, mille tulemust me muutmiseks ei vaja, selles konkreetses TTO projektsioonis ei tagasta me jälgitavaid olemeid niigi.
Seega pole see rida tulemuse jaoks vajalik. Käivitan rakenduse uuesti, et uus marsruut saaks registreeritud. Kontrollime terminalist, et käivitus õnnestus ja läheme tagasi skalari juurde. Saadame tudengite päringu. Siin on 200 jaokk ja meie neli algsed tudengit. Vaata vastuse välju ID ja nimi. East elitid ei ole välja läinud, sest vastuse kuju määrab Student Respons. Raamistik teisendab need objektid Jasoniks. Ka tühi nimekiri oleks selle päringu puhul normaalne tulemus.
Siis tuleks tagasi 200 ja tühi massiiv. Meil on olemas tudengite kogu. Lihtsalt selles ei pruugi parajasti ühtegi kirjet olla. See endpoint töötab. Miks me peaksime seda muutma? Kujutame ette, et andmebaas asub teises serveris. Pärast päringu saatmist tuleb vastust oodata. Sünkroonse andmebaasikutse ajal on seda päringut teenindav lõim ootamisega hõivatud. Asünkroonne andmepöördus võimaldab selle lõime ootamisajaks vabastada.
Vastuse saabudes jätkub meie töö. Nii saab server oma lõimi paremini kasutada, kui korraga on palju ootavaid päringuid. Meie Inn memory näites pole sellist võrguootamist. Siin õpime töövõtet, mitte ei mõõda selle kiiruseelist. Lisame käsitlejale ASNK märksõna. Lisaks võtame vastu cancellation tokeni. See token annab teada, kui HTTP päringu töö on tühistatud. Saame signaali andmepöördusse edasi anda, et töö saaks võimaluse katkeda, kui tulemust enam ei vajata.
See on katkestamise taotlus, mitte lubadus, et iga andmehoidla lõpetab töö samal hetkel. Ait tähendab siin, et jätkame selle tööga siis, kui tulemus on valmis. Kui tulemust veel tuleb oodata, ei pea praegune lõim lihtsalt ootele jääma. Kood jätkub pärast alles siis, kui operatsioon on lõpetanud. Me ei saada kliendile poolikut nimekirja. Tulist asemel kasutame tulistask meetodit ja anname talle katkestussignaali. Meetod tagastab taaski, mille kaudu saame operatsiooni lõpptulemuse.
Oluline on, et Asünk ü arvutust ega andmebaasi päringut kiiremaks. Kui vastuse saamine võtab aega, võtab see endiselt aega. Meie võit on selles, kui server seda ootaega kasutab. Vastus näeb välja samasugune. Neli tudengid, samad väljad, sama oleku kood. Kliendi jaoks abileping ei muutunud. Muutsime andmepöörduse teostust serveri sees. Edaspidi kasutame ka üksikuirje lugemisel ja muudatuste salvestamisel vastavaid asünkroonseid meetodeid.
Nimekirja kõrval tahame küsida üht kindlat tudengit. Lisame aadressi lõppu ID parameetri. Loogilistes sulgudes olev osa on muutuja. Int piirang ütleb masruuterile, et sellele kohale ootame täisarvu. Raamistik annab selle väärtuse käsitlejale intameetrina. Meie kood otsib vastava tudengi. Kui leiame ta, saadame tudengiandmed. Kui ei leia, tagastame 404. See otsus on siis meie enda käsitlejas. Program CS sisaldab nüüd nii rakenduse seadistust kui ka tudengite päringute loogikat.
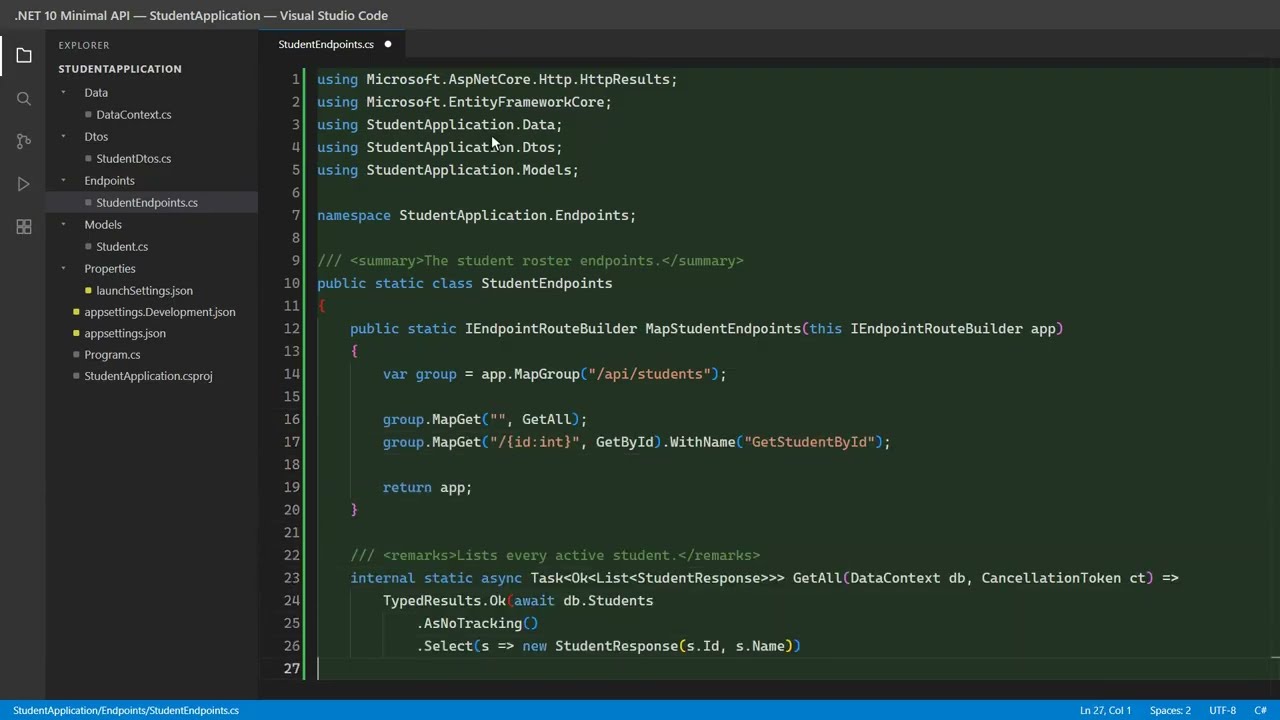
Kohe lisanduvad siia ka muud tegevused. Ee tõstame tudengitega seotud endpointid oma faili. Nii jääb rakenduse käivitus siia ja ühe ressursi tegevused leiame ühest kohast. Loon Student Endpoints klassi. Selle ülemine osa kirjeldab marsruudid ja allpool on neid teenindavad meetodid. Mapgoup annab neile ühise aadressi alguse. Nimekirjapäring jääb grupi juureadressile. Ühe tudengi päringule lisandub ID. Maps student Endpoints on laiendusmeetod.
Selle abil saame program CS-ist kogu selle komplekti ühe kutsega registreerida. Meetod võtab vastu marsruutide registreerija ja lisab meie tudengite aadressid selle külge. Ühe tudengi meetodi tagastustüüp ütleb nüüd, et tulemuseks võib olla tudengi andmetega okvastus või not found. Type results seob meie tagastatud väärtused nende konkreetsete vastuseüüpidega. See aitab nii koodi kontrollida kui ka openi kirjeldust koostada.
Võimalikud põhivastused on nähtavad juba meetodi signatuuris. Program Cis asendame senised tudengite marsruudid Map Students Endpoints kutsega. Siia jätame väikese heal päringu, mis vastab, et rakendus töötab. See kontrollib ainult meie veebirakenduse vastamist. Andmehoidla või teiste teenuste tervisse lihtne käsitleja eraldi ei kontrolli. Lisame viite endpoints nimeruumile. Tto viidet program CS enam ise ei vaja, sestd kasutavad nüüd students endpints klassi meetodid.
Proovime tudengit identifikaatoriga kaks. Saame 200 ja ühe tudengi objekti. Failide paigutus muutus, kuid sama päring annab endiselt sama tulemuse. See on oluline kontroll, kui tõstame koodi ümber ilma käitumist muutmata. Paneme nüüd identifikaatori, mida meie allgandmetes ei ole. Vastus on 404. Endpoint ise on olemas. Puudub just küsitud tudeng ja selle olukorra jaoks kirjutasime oma koodi not found haru. Lisamiseks kasutame varem loodud great student request tüüpi.
Klient annab nime. Ta ei määra selle kaudu ise identifikaatorite ega kustutamise olekut. Nime juures on kirjas, et see on kohustuslik ja piiratud pikkusega. Lisame nüüd add validation kutse, et raamistik neid sisendireegleid kontrolliks. Kui nimi puudub või on liiga pikk, ei ole mõtet tudengi salvestamisega alustada. Valideerimine annab sel juhul kliendile 400 vastuse ja vigade kirjelduse enne meie käsitleja käivitamist.
Need atribuudid kontrollivad siin nimele seatud nõudeid. Kõik rakenduse reeglid ei pruugi nendega piirduda. Kursusepunktide juures tuleb meil kontrollida ka seda, kuidas kaks välja omavahel sobivad. Lisame samale tudengite aadressile Post Marsruudi. Get loeb sellel aadressil nimekirja. Post kutsub välja meie lisamismeetodi. Create meetod saab päringukehast nime ja raamistikult data konteksti. Loome uue student objekti ning lisame selle konteksti.
Save changes asvestab muudatuse. Vastuse jaoks võtame tudengi identifikaatori ja nime loome student responsi. Created at root annab kliendile 2011 vastuse. Lisaks koostab see location päise, kust kohast saab loodud tudengid uuesti küsida. Aadressi leidmiseks kasutame oma detailmarsuudi nime Get Student by ID ja uue tudengi identifikaatorit. Kirjutame nimeks Katikask ja saadame päringu. Vastus on 2011id. Näeme ka loodud tudengi identifikaatorit viis.
Meie sisend sisaldab ainult nime, aga vastuses on nüüd ka kirje identifikaator. Küsime nüüd tudengid viis eraldi kettpäringuga. Ta on olemas ja nimi on sama, mille saatsime. Nii kontrollisime lisaks eduteatele ka seda, et uus kirja on järgmise päringuga leitav. Ainult rohelise olekukoodi vaatamisest selleks ei piisanud. Lisame veel ühe tudengi. Seekord avan vastuse päised. Location näitab loodud tudengi aadressi. Klient ei pea seda aadressi meie vastuse põhjal ise oletama.
Selle koostas raamistik nimega Marsuudi järgi, mille Greet Truutile ette andsime. Mis juhtub siis, kui jätame nime tühjaks? Saadame päringu. Vastus on 400 ja veakirjeldus viitab nimele. Selle kontrolli tegi raamistik meie TTO reeglite järgi. Tudengi loomise käsitlejad selle vigase sisendiga ei käivitatud. Küsime nimekirja uuesti. Siin on endiselt kuus tudengit. Tühja nimega kirjid juurde ei tekkinud. See on vigase päringu juures teine oluline kontroll.
Lisaks veateatele peavad andmed jääma õigesse seisu. Lisame kaks järgmist tegevust. Put muudab olemasoleva tudengi andmeid ja delit kustutab tudengi meie appi tavapärasest vaatest. Mõlemal juhul tuleb tudengi identifikaator aadressist. Muutmisel tuleb uus nimi kaasa päringukehas. Muudame kõigepealt nime. Otsime tudengi identifikaatori järgi. Kui aktiivset tudengit ei leidu, tagastame 404 ja lõpetame selle päringu. Kui tudeng on olemas, määrame uue nime ja salvestame muudatuse.
Meie valitud eduvastus on 204. Muudatus õnnestus, aga vastuse keha ei tule. Selle appi muudetav tudengiinfo koosneb praegu nimest. Sama putt päringu uuesti saatmine jätab nime samaks. See ei lisa uut tudengit ega muuda tulemust iga kord uuesti teistsuguseks. Kustutamisel otsime samuti aktiivse tudengi. Kui teda ei ole, vastame 404. Leitud tudengil määrame East eliitid väärtuseks true ja salvestame. Kirjet me andmehoidlast ei eemalda.
Tavalistest päringutest kaob ta varem lisatud päringufiltri tõttu. Siin saavad mudeli väli ja data konteksti filter kokku. Üks muudab kirjaolekut, teine arvestab seda lugemisel. Pärast taaskäivitust alustame jälle nelja algse tudengiga. Eelmises katses lisatud kaks tudengit olid eelmise protsessi mälus. Valime tudengi kaks ja saadame talle uue nime. Vastus on 204. vastuse keha on tühi nii nagu me meetodis kokku leppisime.
Küsime tudengid kaks uuesti. Siin on nüüd uus nimi. Muutmispäring andis eduvastuse ja järgnev lugemine kinnitas, et muudatus on olemas. Kui oleksime kasutanud puuduvad identifikaatorit, oleks meie kood jõudnud hoopis not found harusse. Kustutame tudengi neli. Vastuseks saame 204. Meie abi vaates on kustutamine tehtud. Mis juhtub, kui saadame täpselt sama kustutamispäringu uuesti? Nüüd saame 404. Meie tavapärane päring aktiivset tudengit enam ei leia.
Kustutamise mõju aga ei muutu. Teise päringu järel on tudeng endiselt kustutatud ja midagi täiendavat ei kustutata. Seda omadust nimetame idempotentsuseks. Vastusekood võib kordamisel erineda, kuigi soovitud mõju jääb samaks. Proovime nüüd sama tudengit lugeda. Ka detailpäring annab 404. Get by ID ei vaja eraldi kopeeritud kustutamise tingimust. FCOR rakendab talle sama üldist päringufiltrit, mille data kontekstis seadistasime.
Nimekirjas on nüüd kolm tudengit. Tudeng neli sealt enam välja ei tule. Meie kustutamiskood muutis ainult IT liit väärtust, seega kirje ise jäi andmehoidlasse. Ef koor võimaldab üldfiltrist ka teadlikult mööda minna, näiteks haldusfunktsiooni jaoks. Meie praegustes avalikes endpointides sellist päringut ei ole. Lisame päringu, mis tagastab ainult aktiivsete tudengite arvu. Selleks ei pea klient tervet nimekirja alla laadima ja ise kokku lugema.
Ka üks arv on korrektne Jason vastus. Kõik vastused ei pea olema objektid või massiivid. Count asünk loendab päringule vastavad tudengid. Ka sellele päringule rakendub meie üldfilter. Nii et kustutatuks märgitud tudengite arvu sisse ei lähe. Saadame count päringu. Vastus on arv neli. Count on selle marsruudi kindel teksti osa. Üksiku tudengi marsuudis ootama ka täisarvu. Nii on meil samas grupis olemas nii loendur kui ka ühe tudengi küsimine.
Enne taaskäivitust nägime kolme aktiivset tudengit. Nüüd on neid jälle neli. Kustutatud tudeng on tagasi ja muudetud nimi on samuti algne. In memory hoidis muudatusi eelmise protsessi mälus. Uus protsess alustas meie koodis kirjeldatud algandmetest. Tudengi nime kõrval tahame nüüd hoida tema tulemusi. Üks punktikirje kirjeldab näiteks ühe hinnatava ülesande tulemust. mille eest punktid tulid, mitu punkti saadi ja kui palju oli võimalik saada.
Loon selleks Course Point ressursi. Iga kirje kuulub ühele tudengile. Selle näitega saame vaadata nii seotud andmete küsimist kui ka ühtpäris käitumisreeglid. Punktikirjel on oma identifikaator ja student ID, mis näitab, millisele tudengile tulemus kuulub. Description kirjeldab tulemust. Points ja maksimum points hoiavad saadud ning võimalikke punkte. Alustame tavalisest mudelist. Loomise reegli lisame siis, kui hakkame uusi tulemusi vastu võtma.
Ka punktikirja vastuse jaoks teeme eraldi TTO. Siin on väljad, mida klient selle tulemuse kohta näeb. Lisame data konteksti Course Points kogu, mille kaudu saame punktikirjaid küsida ja lisada. Esimesel tudengil on algandmetes kaks tulemust, 70 ja 1820st. Teisel tudengil on üks tulemus, kolmandal pole veel ühtegi. Student ID väärtuse kaudu seostame iga tulemuse tudengiga. Selles näites kasutame seda seost oma päringutes ise.
In memory peale me välisvõtmete kontrolli ei jäta. Algandmed peavad omavahel sobima ja appis kontrollime tudengi olemasolu. Punktide päringut koondame point end points faili. Aadressis on kõigepealt tudeng ja tema järel points. Nii küsime ühe kindla tudengi tulemusi, mitte kõiki tulemusi segamini. Kontrollime esmalt, kas aktiivne tudeng on olemas. Kui teda pole, vastame 404. Kui ta on olemas, küsime just tema punktikirjeid ja vormistame need vastused ttooodeks.
Programm CSis lisame punktide endpintid ühe kutsega juurde. Tudengite ja punktide loogika on eri failides, aga käivitusfailist näeme endiselt kiiresti, millised osad rakendusse kuuluvad. Tudengi detailis tahame nüüd näha ka tulemuste summat. Nime kõrvale lisame, mitu punkti tudeng kokku sai ja mitu punkti oli kokku võimalik saada. Selle vastuse jaoks loome studentif points responsi. Summad on arvutatud andmed, mitte uued väljad student olemis.
Detailpäring võtab endiselt tudengiidentifikaatori ja nime. Lisaks leiab see sama tudengi punktikirjad ning arvutab neist kaks summat. Mõlemal summal peab olema õige tudengitingimus. Vastasel korral võime kogemata liita kokku kogu kursuse tulemused. Me ei salvesta neid summasid eraldi. Need arvutatakse olemasolevatest kirjetest, nii et uue tulemuse lisamisel peegeldab järgmine päring uut seisu. Küsime esimese tudengipunkte.
Vastuses on tema kaks algset tulemust. Teise tudengi tulemust siin ei ole, sest päring filtreeris kirj tudengi identifikaatori järgi. Kolmandal tudengil pole veel tulemusi. Kas see peaks olema viga? Meie api vastab 200 ja tühja massiiviga. Tudeng on olemas. Lihtsalt tema tulemuste kogu on praegu tühi. Identifikaatoriga 99 tudengit ei ole. Nüüd saame 404, sest meie kood kontrollib tudengi olemasolu enne punktide küsimist.
Tühi tulemuste kogu ja puuduveng on kaks erinevat olukorda. Tudengi detailis on nüüd kokku 25 saadud punkti ja 30 võimalikku punkti. Need tulevad tema kahest tulemusest, 70st ning 1820st. Nimi ja identifikaator tulevad tudengi andmetest, summad tema punktikirjatest. Klient saab need ühe vastusega. Punktid on seni tulnud algandmetest. Lisame võimaluse uus tulemus appi kaudu kirja panna. Post läheb tudengipunktide aadressile.
Student ID tuleb aadressist. Päringu kehast saadame kirjelduse ning saadud ja võimalikud punktid. Sama tudengi identifikaatorit pole kehas vaja teist korda küsida. Kirjeldus peab olema täidetud. Saadud punktid võivad olla null või suuremad. Võimalik punktisumma peab olema vähemalt üks. Need tingimused kirjutame sisendi TTO atribuutidesse. Aga üks oluline kontroll on veel puudu. Proovime mõttes üht tulemust. 11 punkti 10st.
Mõlemad arvud sobivad eraldi meie praeguste range kontrollidega, aga koos kirjeldavad need tulemust, mida me ei luba. Meil on vaja kontrollida nende omavahelist seost. Saadud punkte ei tohi olla rohkem kui võimalikke punkte. See on meie näite domeenireegel. Paneme selle punktikirja loomise meetodisse, et rakenduse erikasutuskohad saaksid kasutada sama kontrollitud loomise viisi. Muudame punktikirja omaduste setterit privaatseks ja lisame create meetodi.
Rakenduse kood loob uue punktikirja selle meetodi kaudu. Meetod korrastab kirjelduse, kontrollib nõutud väärtusi ning võrdleb saadud punkte maksimumiga. Kui tingimused ei sobi, tekib viga. Kui sobivad, saame korrektse punkti kirja. Tto kontroll aitab vigase HTTP sisendi varakult tagasi lükata. Create meetod kontrollib väärtusi ka siis, kui rakenduse kood kutsub seda mujalt. Meie hääst data allkirjad sellest meetodist läbi ei käi.
Need etteantud näidisandmed peame eraldi korrektsõna hoidma. Käsitleja esimene kontroll on endiselt tudeng. Kas selline aktiivne tudeng on olemas? Kui ei ole, tagastame 404 ega alusta punktikirje loomist. Seejärel kutsume välja Corse Point Create meetodi. Kui see lükkab väärtused tagasi, vormistab käsitleja vea 400 vastuseks. Püüame kinni just selle kontrolli vea, mitte kõiki võimalikke rakenduse vigu. Korrektse kirja lisame konteksti, salvestame ja tagastame 2011 koos vastuse TTO-ga.
Sellel appil pole üksiku punktikirja detailadressi. Seetõttu ei lisa me väljamõeldud location päist. Tulemus saab küsida tudengipunktide nimekirjast. Lisame esimesele tudengile seitse punkti kümnest. Vastus on 2011 ja näeme loodud punktikirjad. Lisame nüüd nullpunkti kümnest. See on samuti lubatud tulemus. Nullpunkti tähendab, et tulemus on kirjas, kuigi punkti ei saadud. See ei ole sama, mis tulemuse puudumine. Mis vastuse peaks andma 11 punkti 10st?
Saame 400. Veateade ütleb, et punktid peavad jääma lubatud vahemikku. Need väärtused lükkas tagasi meie create meetod ja endpoint muutis selle vea http vastuseks. Viimaseks proovime lisada korrektset tulemust tudengile 99. Sellist tudengit ei ole, seega vastus on 404 ja punktikirjet ei looda. Siin kontrollisime teist reeglit. Kõigepealt peab olema tudeng, kellele tulemus kuulub. Kontrollime veel üht seost. Kustutame tudengi neli ja proovime talle seejärel uut tulemust lisada.
Punktide lisamine annab nüüd 404. Punktide endpint küsib samuti aktiivse tudengi olemasolu ja tema päringule rakendub sama üldfilter. Meie avaliku appi jaoks on tudeng kustutatud, kuigi East Deli True väärtusega kirje on andmehoidlas endiselt olemas. Küsime esimese tudengi detaili uuesti. Saadud punkte on nüüd 32 ja võimalikke punkte 50. Saadud punktidele lisandus seitse, võimalik punktidele lisandus 2 kord 10, sest ka nullpunktine tulemus on kirjas. 11 punkti künnest tagasi lükatud katsest summasse ei jõudnud.
Nii näeme, et lisamine, kontrollreeglid ja koondpäring sobivad omavahel kokku. Programm CS jäi meil üsna lühikeseks. Siin on teenuste ja andmehoidla seadistus ning tudengite ja punktide endpointide registreerimine. Päringute loogika asub oma failides. Skalaris on näha valminud appi. Saame tudengid hallata, neile tulemusi lisada ja punktisummasid küsida. Kontrollisime nii õnnestuvaid päringuid kui ka vigast sisendit ja puuduvaid tudengeid.
Selle näite juures on oluline, et oskaksid jälgida kogu päringu teed sisendist kontrollide ja andmete kasutamiseni ning sealt HTTP vastuseni. TTO-d kirjeldavad üle appi liikuvaid andmeid. Endpoint korraldab päringutöö. Punktikirje loomismeetod kontrollib oma reegleid ja tulemust kontrollime päriselt päringut saates.
The words are the caption track's own and nothing is reworded or re-transcribed. Paragraph breaks are placed between sentences so the text reads as prose.
Free tools for your own script: paste a draft and see where it stands before you record it.
Paste your draft and see where viewers are likely to drop off, with a rewrite for each weak line.
Paste the first 30 seconds of your own draft for a hook score and rewrites.
Check your draft against YouTube's advertiser-friendly guidelines before you record it.
Read this channel's public videos and transcripts, and download a writing brief for it.